Qué hace el control de rastreadores de IA
No todos los rastreadores de IA hacen lo mismo. Unos copian tus páginas para entrenar modelos, otros las indexan para que un motor de respuestas te cite con un enlace y otros abren una página porque un usuario de un asistente la ha pedido. WP Masquerade Pro clasifica 37 rastreadores conocidos en cuatro familias y te deja decidir, para cada una, si permitirla, bloquearla o permitir solo algunas rutas de tu sitio.
| Familia | Qué hacen estos rastreadores | Ejemplos | robots.txt, según sus empresas |
|---|---|---|---|
| Entrenamiento de modelos de IA (19 rastreadores) | Recopilan contenido para entrenar modelos. Tus páginas no te aportan nada a cambio. | GPTBot, ClaudeBot, Google-Extended, Applebot-Extended, CCBot, Meta-ExternalAgent, Bytespider | Respetado por la mayoría; Google-Extended y Applebot-Extended son solo indicaciones de robots.txt; varios no tienen ninguna documentación de su empresa |
| Búsqueda y respuestas de IA (8 rastreadores) | Indexan las páginas para que los buscadores y asistentes de IA las citen con un enlace. Sus empresas afirman que no las usan para entrenar. | OAI-SearchBot, Claude-SearchBot, PerplexityBot, DuckAssistBot, MistralAI-Index | Respetado |
| Consultas pedidas por usuarios (8 rastreadores) | Un usuario de ChatGPT, Claude, Perplexity o Meta AI pregunta por una página y el asistente la abre. | ChatGPT-User, Claude-User, Perplexity-User, Meta-ExternalFetcher, Google-Agent | Varias empresas indican que robots.txt puede no aplicarse: solo el bloqueo estricto los detiene |
| Extracción de datos e índices de imágenes (2 rastreadores) | Extraen datos o indexan imágenes para otros productos. | Diffbot, ImagesiftBot | Respetado |
Los buscadores clásicos nunca se ven afectados: Googlebot, Bingbot, Applebot, DuckDuckBot, Qwantbot y los robots de vista previa de enlaces de las redes sociales siempre están permitidos, elijas lo que elijas.
Por qué elegir por familia
Bloquearlo todo es sencillo, pero entonces también desapareces de las respuestas de los buscadores con IA, que envían cada vez más visitas: un asunto real de GEO. Permitirlo todo deja que cualquier rastreador copie tus textos para entrenar un modelo, sin enlace ni visita a cambio. Lo más habitual es quedarse en un punto intermedio: que te citen, pero no servir de material de entrenamiento. Es justo lo que hace la primera de las tres elecciones rápidas.
Escribir a mano las reglas del robots.txt obliga a conocer el nombre exacto de cada rastreador, a seguir los nuevos, y aun así no sirve de nada contra los que ignoran el archivo. La pestaña reúne los dos mecanismos y mantiene la lista al día por ti.
Qué incluye Función Pro
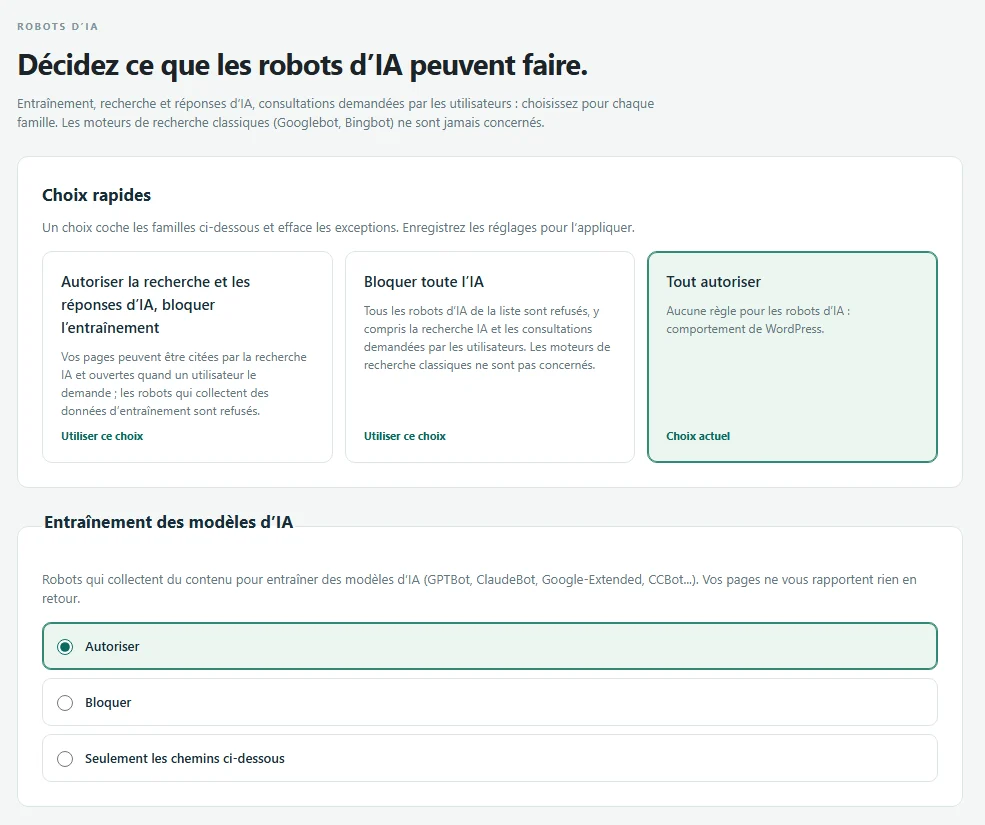
- Tres elecciones rápidas: «Permitir la búsqueda y las respuestas de IA, bloquear el entrenamiento», «Bloquear toda la IA» y «Permitir todo».
- Para cada familia: Permitir, Bloquear o Solo las rutas de abajo (hasta 20 rutas con la sintaxis de robots.txt, por ejemplo /blog/ o /docs/*.html$).
- Excepciones rastreador por rastreador, cada uno con su empresa y lo que dice su documentación: respeta robots.txt, puede ignorarlo, solo indicación de robots.txt o sin documentar.
- Reglas de robots.txt añadidas al robots.txt virtual de WordPress, con una vista previa de las líneas generadas. Si existe un archivo robots.txt físico o el sitio está instalado en una subcarpeta, se detecta y la pestaña muestra las líneas que hay que copiar.
- Un bloqueo estricto opcional: los rastreadores bloqueados que se identifican en su agente de usuario reciben una respuesta 403 o 404 desde el inicio de la petición, lean o no el robots.txt.
- Un contador de solicitudes rechazadas por rastreador en 7 y 30 días, sin guardar direcciones IP ni páginas.
- El modo «Máximo» del asistente de inicio pide a los rastreadores de entrenamiento y de extracción de datos que se mantengan al margen (solo mediante robots.txt).
- Estas elecciones forman parte de los ajustes exportados: una sección propia de importar y exportar ajustes las copia en tus otros sitios.
Cómo configurarlo
- Abre WP Masquerade → Rastreadores de IA (el icono de máscara del menú de administración).
- Haz clic en una de las Elecciones rápidas o ajusta cada familia tú mismo. Si eliges «Solo las rutas de abajo», escribe las rutas permitidas, una por línea.
- Si hace falta, abre la lista de rastreadores para dar a uno de ellos una regla distinta.
- En «Cómo se aplican las elecciones», activa las reglas de robots.txt y, si quieres, el bloqueo estricto con la respuesta 403 o 404. Ambos están desactivados hasta que los actives.
- Guarda y haz clic en Abrir robots.txt para comprobar las líneas añadidas.
Con la elección «Permitir la búsqueda y las respuestas de IA, bloquear el entrenamiento», el robots.txt recibe un grupo como este (extracto):
# AI crawlers
User-agent: GPTBot
User-agent: ClaudeBot
User-agent: Google-Extended
User-agent: Applebot-Extended
User-agent: CCBot
User-agent: Diffbot
Disallow: /
Límites y precauciones
- robots.txt es una petición, no un candado: los rastreadores serios la respetan, otros la ignoran o recorren la web sin identificarse.
- El bloqueo estricto se basa en el agente de usuario que anuncia el rastreador. Uno que se haga pasar por un navegador normal no se reconoce.
- Las páginas servidas desde una caché del servidor o una CDN no llegan a WordPress, así que el bloqueo estricto no las ve. En ese caso, robots.txt es la única señal.
- Google-Extended, Applebot-Extended y la indicación común __usage_ai-training no tienen agente de usuario propio: solo robots.txt puede expresarlos.
- Bloquear hoy un rastreador no borra lo que ya ha recopilado, ni nada de los modelos ya entrenados.
- No se envía ninguna cabecera ni metaetiqueta «noai»: ninguna gran empresa de IA documenta que las tenga en cuenta.
- Los usuarios conectados, la administración, el cron, las peticiones REST y AJAX y tus direcciones de confianza nunca se rechazan. Si algo falla, una constante en wp-config.php desactiva el bloqueo estricto.
¿Varios sitios? Ajusta tus elecciones una vez, guárdalas en un perfil de ajustes y aplícalo a los sitios de tus clientes desde el panel de agencia de tu área de cliente, en los sitios que lo hayan autorizado.
Preguntas frecuentes sobre los rastreadores de IA
¿Bloquear los rastreadores de IA perjudica mi posicionamiento en Google?
No. Googlebot y Bingbot nunca se bloquean. Google indica que Google-Extended, la indicación para rechazar el entrenamiento de sus modelos Gemini, no influye en la inclusión ni en la clasificación en la Búsqueda de Google. Las vistas creadas con IA de Google forman parte de la búsqueda y dependen de Googlebot, así que este ajuste no las toca.
¿Qué diferencia hay entre entrenamiento y búsqueda?
Un rastreador de entrenamiento copia tus páginas para mejorar un modelo: el texto se convierte en materia prima, sin enlace hacia ti. Un rastreador de búsqueda indexa tus páginas para que un asistente las cite al responder, normalmente con un enlace. OpenAI, por ejemplo, separa GPTBot (entrenamiento) y OAI-SearchBot (búsqueda en ChatGPT).
¿Va a desaparecer mi contenido de ChatGPT?
Lo que ya se recopiló, no: un modelo entrenado conserva lo que aprendió. Bloquear GPTBot impide las recopilaciones futuras para el entrenamiento. Si bloqueas también la familia «Búsqueda y respuestas de IA», tus páginas dejan de indexarse para la búsqueda de ChatGPT y renuncias a que te cite.
Ya tengo un archivo robots.txt en el servidor, ¿qué pasa?
Un archivo robots.txt físico lo sirve directamente el servidor y sustituye al de WordPress: el plugin no puede añadirle sus reglas. La pestaña lo detecta y muestra las líneas que debes pegar al final de tu archivo. Lo mismo ocurre con un sitio instalado en una subcarpeta, porque los rastreadores solo leen el robots.txt de la raíz del dominio.
¿Conviene activar el bloqueo estricto?
Solo si robots.txt no basta, por ejemplo para las consultas pedidas por usuarios, que varias empresas no someten a robots.txt. El contador de solicitudes rechazadas te muestra después quién insiste. Elige 404 si prefieres que el rastreador crea que la página no existe en lugar de ver que está prohibida.
Empieza gratis y pasa a Pro cuando estés listo
La versión gratuita ya oculta WordPress, cambia la dirección de la página de acceso, bloquea XML-RPC y cuenta los robots. Pro blinda los accesos, renombra las direcciones de los archivos y vigila tus sitios por ti: vulnerabilidades conocidas, integridad del núcleo, registro de actividad, alertas por correo y estado de las actualizaciones de todos tus sitios en tu área de cliente. Desde 59 € al año sin IVA, mucho menos que las ofertas de limpieza cuyos precios hemos consultado. Comparar los costes.