Was die KI-Crawler-Kontrolle leistet
KI-Crawler erledigen nicht alle dieselbe Aufgabe. Manche kopieren deine Seiten, um Modelle zu trainieren, andere indexieren sie, damit eine Antwortmaschine dich mit Link zitieren kann, und wieder andere rufen eine Seite auf, weil ein Nutzer eines Assistenten danach gefragt hat. WP Masquerade Pro ordnet 37 bekannte Crawler vier Familien zu. Für jede Familie entscheidest du: erlauben, sperren oder nur bestimmte Pfade deiner Website freigeben.
| Familie | Was diese Crawler tun | Beispiele | robots.txt laut Anbieter |
|---|---|---|---|
| Training von KI-Modellen (19 Crawler) | Sammeln Inhalte, um Modelle zu trainieren. Deine Seiten bringen dir dafür nichts zurück. | GPTBot, ClaudeBot, Google-Extended, Applebot-Extended, CCBot, Meta-ExternalAgent, Bytespider | Von den meisten befolgt; Google-Extended und Applebot-Extended sind reine robots.txt-Token; mehrere Crawler haben gar keine Dokumentation ihres Anbieters |
| KI-Suche und -Antworten (8 Crawler) | Indexieren Seiten, damit KI-Suchmaschinen und Assistenten sie mit Link zitieren können. Laut Anbieter werden diese Inhalte nicht für das Training genutzt. | OAI-SearchBot, Claude-SearchBot, PerplexityBot, DuckAssistBot, MistralAI-Index | Befolgt |
| Von Nutzern angeforderte Abrufe (8 Crawler) | Ein Nutzer von ChatGPT, Claude, Perplexity oder Meta AI fragt nach einer Seite, und der Assistent ruft sie auf. | ChatGPT-User, Claude-User, Perplexity-User, Meta-ExternalFetcher, Google-Agent | Mehrere Anbieter erklären, dass robots.txt hier nicht gelten muss: nur die harte Sperre hält sie auf |
| Datenextraktion und Bildindizes (2 Crawler) | Extrahieren Daten oder indexieren Bilder für andere Produkte. | Diffbot, ImagesiftBot | Befolgt |
Klassische Suchmaschinen sind nie betroffen: Googlebot, Bingbot, Applebot, DuckDuckBot, Qwantbot und die Linkvorschau-Bots sozialer Netzwerke bleiben immer erlaubt, egal was du einstellst.
Warum nach Familien entscheiden
Alles zu sperren ist einfach, aber dann verschwindest du auch aus den Antworten der KI-Suchmaschinen, die immer mehr Besucher schicken: ein echtes GEO-Thema. Alles zu erlauben heißt, dass jeder Crawler deine Texte für das Training eines Modells kopieren darf, ohne Link oder Besuch als Gegenleistung. Die meisten wählen den Mittelweg: zitiert werden, aber kein Trainingsmaterial sein. Genau das macht die erste der drei Schnellauswahlen.
Wer robots.txt-Regeln von Hand schreibt, muss den genauen Namen jedes Crawlers kennen, neue im Blick behalten und hat trotzdem nichts gegen die, die die Datei ignorieren. Der Tab vereint beide Mechanismen und hält die Liste für dich aktuell.
Was enthalten ist Pro-Funktion
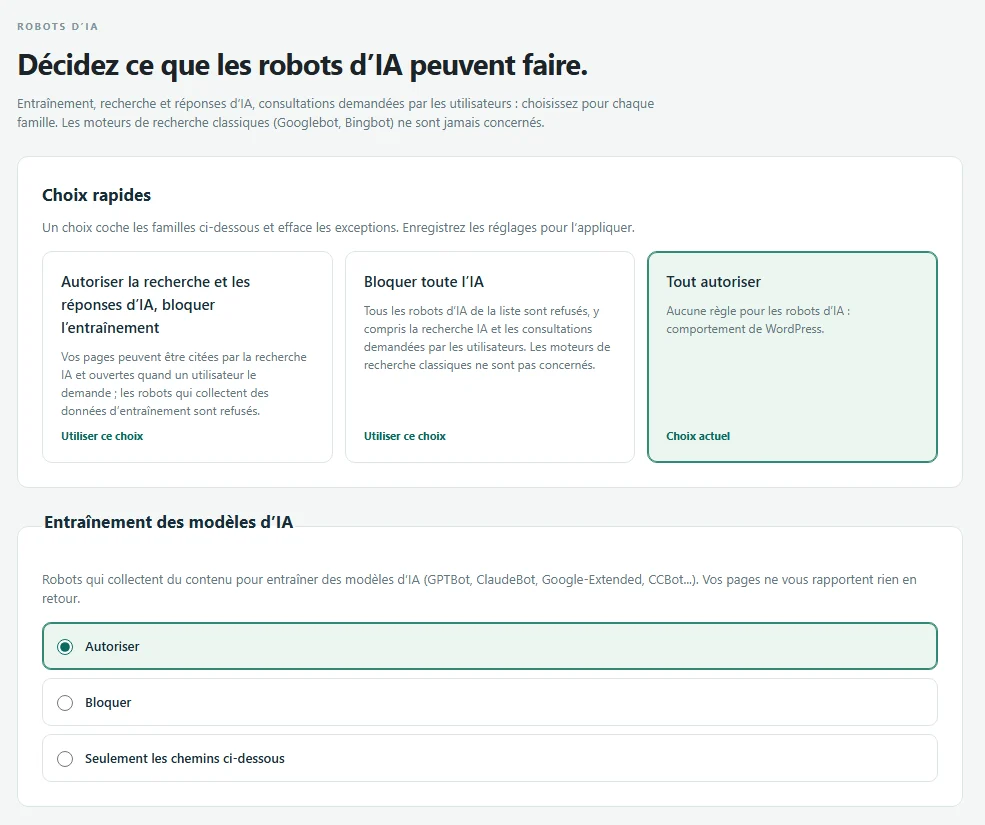
- Drei Schnellauswahlen: „Suche und KI-Antworten erlauben, Training blockieren“, „Alle KI blockieren“ und „Alles erlauben“.
- Für jede Familie: Erlauben, Sperren oder Nur die Pfade unten (bis zu 20 Pfade in robots.txt-Syntax, zum Beispiel /blog/ oder /docs/*.html$).
- Ausnahmen für einzelne Crawler, jeweils mit Anbieter und dem, was seine Dokumentation sagt: befolgt robots.txt, kann es ignorieren, reines robots.txt-Token oder nicht dokumentiert.
- robots.txt-Regeln, die der virtuellen robots.txt von WordPress hinzugefügt werden, mit einer Vorschau der erzeugten Zeilen. Eine physische robots.txt-Datei oder eine Installation in einem Unterordner wird erkannt; der Tab zeigt dann die Zeilen zum Kopieren.
- Eine optionale harte Sperre: Gesperrte Crawler, die sich in ihrem User-Agent zu erkennen geben, erhalten gleich zu Beginn der Anfrage eine 403- oder 404-Antwort, ob sie robots.txt lesen oder nicht.
- Ein Zähler abgewiesener Anfragen pro Crawler über 7 und 30 Tage, ohne gespeicherte IP-Adressen oder Seiten.
- Der Modus „Maximal“ des Einrichtungsassistenten bittet Trainings- und Datenextraktions-Crawler, fernzubleiben (nur per robots.txt).
- Diese Auswahl gehört zu den exportierten Einstellungen: Ein eigener Abschnitt beim Importieren und Exportieren der Einstellungen überträgt sie auf deine anderen Websites.
So richtest du sie ein
- Öffne WP Masquerade → KI-Crawler (Masken-Symbol im Admin-Menü).
- Klicke auf eine der Optionen unter Schnellauswahl oder stelle jede Familie selbst ein. Wenn du „Nur die Pfade unten“ wählst, trage die erlaubten Pfade ein, einen pro Zeile.
- Öffne bei Bedarf die Crawler-Liste, um einem einzelnen Crawler eine andere Regel zu geben.
- Schalte unter „Wie die Auswahl angewendet wird“ die robots.txt-Regeln ein und, wenn du möchtest, die harte Sperre mit 403- oder 404-Antwort. Beides bleibt aus, bis du es einschaltest.
- Speichere und klicke auf robots.txt öffnen, um die hinzugefügten Zeilen zu prüfen.
Mit der Auswahl „Suche und KI-Antworten erlauben, Training blockieren“ erhält die robots.txt eine Gruppe wie diese (Auszug):
# AI crawlers
User-agent: GPTBot
User-agent: ClaudeBot
User-agent: Google-Extended
User-agent: Applebot-Extended
User-agent: CCBot
User-agent: Diffbot
Disallow: /
Grenzen und Vorsichtsmaßnahmen
- robots.txt ist eine Bitte, kein Schloss: Seriöse Crawler halten sich daran, andere ignorieren sie oder crawlen, ohne sich zu erkennen zu geben.
- Die harte Sperre stützt sich auf den User-Agent, den der Crawler angibt. Ein Crawler, der sich als gewöhnlicher Browser ausgibt, wird nicht erkannt.
- Seiten aus einem Server-Cache oder einem CDN erreichen WordPress nicht, die harte Sperre sieht sie also nicht. Dann bleibt robots.txt das einzige Signal.
- Google-Extended, Applebot-Extended und das gemeinsame Token __usage_ai-training haben keinen eigenen User-Agent: Nur robots.txt kann sie ansprechen.
- Einen Crawler heute zu sperren, entfernt nicht, was er schon gesammelt hat, und nichts aus bereits trainierten Modellen.
- Es wird kein „noai“-Header und kein „noai“-Meta-Tag gesendet: Kein großer KI-Anbieter dokumentiert, dass er sie beachtet.
- Angemeldete Nutzer, die Verwaltung, Cron, REST- und AJAX-Anfragen sowie deine vertrauenswürdigen Adressen werden nie abgewiesen. Bei Problemen schaltet eine Konstante in der wp-config.php die harte Sperre ab.
Mehrere Websites? Lege deine Auswahl einmal fest, speichere sie in einem Einstellungsprofil und wende es über das Agentur-Dashboard deines Kundenbereichs auf die Kunden-Websites an, die das erlaubt haben.
Häufige Fragen zu KI-Crawlern
Schadet das Sperren von KI-Crawlern meinem Google-Ranking?
Nein. Googlebot und Bingbot werden nie gesperrt. Google erklärt, dass Google-Extended, mit dem man das Training der Gemini-Modelle ablehnt, keinen Einfluss auf die Aufnahme oder das Ranking in der Google-Suche hat. Die KI-Übersichten von Google gehören zur Suche und hängen von Googlebot ab, diese Einstellung berührt sie also nicht.
Was ist der Unterschied zwischen Training und Suche?
Ein Trainings-Crawler kopiert deine Seiten, um ein Modell zu verbessern: Der Text wird zu Rohmaterial, ohne Link zu dir. Ein Such-Crawler indexiert deine Seiten, damit ein Assistent sie in einer Antwort zitieren kann, meist mit Link. OpenAI trennt zum Beispiel GPTBot (Training) und OAI-SearchBot (Suche in ChatGPT).
Verschwinden meine Inhalte aus ChatGPT?
Nicht das, was schon gesammelt wurde: Ein trainiertes Modell behält, was es gelernt hat. Wer GPTBot sperrt, verhindert künftiges Sammeln für das Training. Sperrst du auch die Familie „KI-Suche und -Antworten“, werden deine Seiten nicht mehr für die ChatGPT-Suche indexiert, und du verzichtest darauf, dort zitiert zu werden.
Ich habe schon eine robots.txt-Datei auf dem Server. Was passiert dann?
Eine physische robots.txt-Datei liefert der Webserver direkt aus, sie ersetzt die von WordPress: Das Plugin kann dort keine Regeln ergänzen. Der Tab erkennt die Datei und zeigt die Zeilen, die du am Ende einfügen musst. Dasselbe gilt für eine Installation in einem Unterordner, denn Crawler lesen nur die robots.txt im Stammverzeichnis der Domain.
Sollte ich die harte Sperre einschalten?
Nur wenn robots.txt nicht reicht, etwa bei von Nutzern angeforderten Abrufen, die mehrere Anbieter nicht an robots.txt binden. Der Zähler abgewiesener Anfragen zeigt dir danach, wer es weiter versucht. Wähle 404, wenn der Crawler die Seite lieber für nicht vorhanden halten soll, statt zu sehen, dass sie gesperrt ist.
Starte kostenlos und wechsle zu Pro, wenn du so weit bist
Die kostenlose Version versteckt WordPress bereits, verlegt die Anmeldeseite, sperrt XML-RPC und zählt die Bots. Pro sichert die Anmeldungen ab, benennt die Dateiadressen um und überwacht deine Websites für dich: bekannte Sicherheitslücken, Integrität des Kerns, Aktivitätsprotokoll, E-Mail-Benachrichtigungen und Update-Status all deiner Websites in deinem Kundenbereich. Ab 59 € netto pro Jahr, deutlich weniger als die Bereinigungsangebote, deren Preise wir erhoben haben. Kosten vergleichen.