
GPTBot, ClaudeBot, PerplexityBot, Google-Extended, Applebot-Extended: de logbestanden van je server en de handleidingen over robots.txt raken vol nieuwe namen. Moet je ze allemaal blokkeren om je content te beschermen, of ze allemaal binnenlaten om door assistenten te worden geciteerd? Standaard geen van beide. Dit artikel maakt onderscheid tussen bots die modellen trainen en bots die live antwoorden voeden, legt uit wat elke blokkade aan zichtbaarheid kost en laat zien hoe je de serverbelasting beperkt zonder onzichtbaar te worden.
Drie toepassingen, drie families van bots
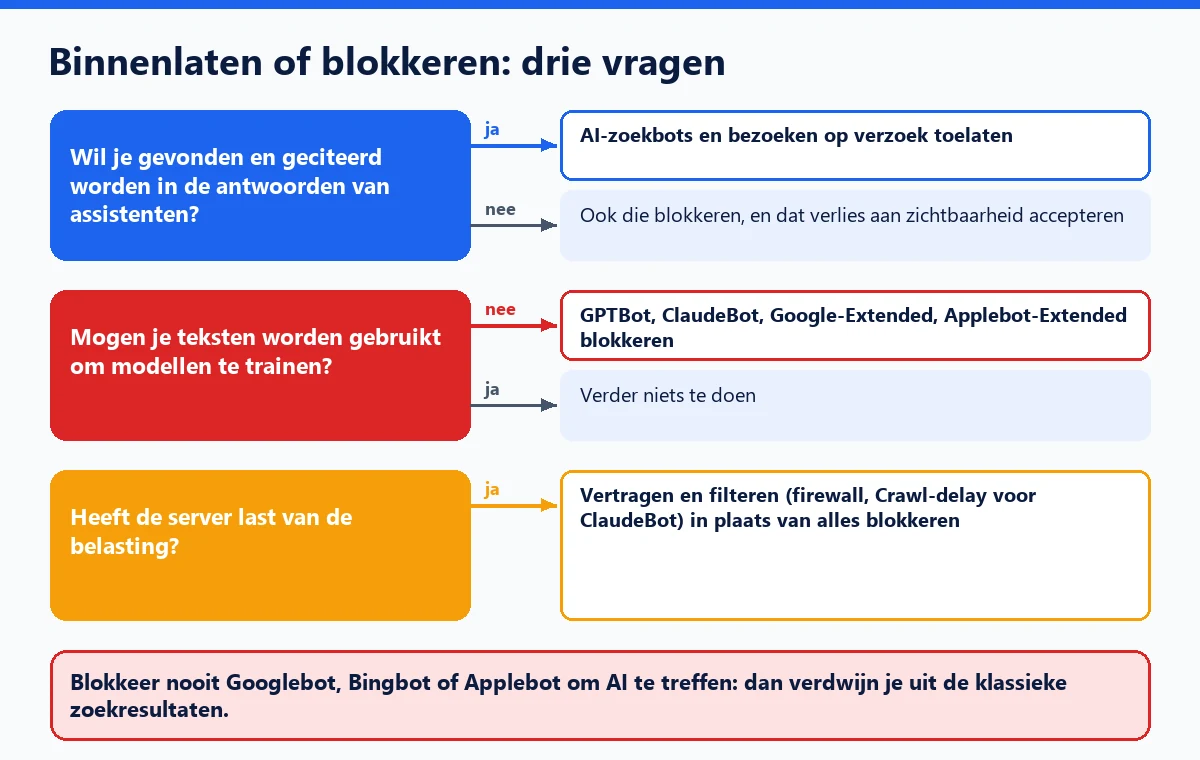
AI-bedrijven hebben hun bots geleidelijk opgesplitst naar het gebruik van de verzamelde pagina's. Die opsplitsing is de sleutel tot elke beslissing:
- Training: de pagina's dienen als trainingsdata voor toekomstige modellen. Deze bot blokkeren haalt niets weg uit de huidige antwoorden, en je krijgt er geen enkel rechtstreeks bezoek van.
- De AI-zoekindex: net als een zoekmachine crawlt en indexeert de bot om je pagina's in antwoorden te kunnen citeren en linken. Dit is de kern van GEO.
- Bezoek op verzoek: een gebruiker stelt een vraag en de assistent leest live een pagina om te antwoorden. Dat is geen automatische crawl, wat bij sommige bedrijven de status van robots.txt verandert.

Wat de bedrijven zeggen, bot voor bot
OpenAI
Volgens de documentatie van OpenAI dient GPTBot om de foundationmodellen nuttiger en veiliger te maken; hem weigeren geeft aan dat de content niet voor training mag worden gebruikt. OAI-SearchBot dient om sites te laten verschijnen in de zoekfuncties van ChatGPT. ChatGPT-User hoort bij acties die een gebruiker start, waarvoor OpenAI waarschuwt dat de regels van robots.txt mogelijk niet gelden. OpenAI geeft aan dat het na een wijziging van robots.txt ongeveer 24 uur duurt voordat de zoeksystemen zich aanpassen, en publiceert de lijst met IP-adressen van elke bot.
Anthropic
Het helpcentrum van Anthropic (artikel van 7 april 2026) beschrijft ClaudeBot, die content verzamelt die kan bijdragen aan training, Claude-SearchBot, die de kwaliteit van zoekresultaten verbetert, en Claude-User, die een pagina ophaalt wanneer een gebruiker een vraag stelt. Anthropic geeft aan dat zijn bots robots.txt respecteren, de niet-standaard extensie Crawl-delay ondersteunen en niet proberen CAPTCHA's te omzeilen. Het licht ook de gevolgen van een blokkade toe: ClaudeBot beperken sluit toekomstige content uit van training, terwijl Claude-SearchBot of Claude-User blokkeren je zichtbaarheid in de antwoorden kan verminderen.
Perplexity
PerplexityBot dient om sites te laten verschijnen en te linken in de resultaten van Perplexity, en wordt volgens de documentatie niet gebruikt om foundationmodellen te trainen. Perplexity-User bezoekt een pagina op verzoek van een gebruiker en negeert, omdat het verzoek van een persoon komt, doorgaans de regels van robots.txt. Beide lijsten met IP-adressen worden in JSON gepubliceerd.
Google-Extended is geen bot maar een robots.txt-token: het heeft geen eigen user-agent, het crawlen gebeurt met de gewone bots van Google. Het bepaalt of content wordt gebruikt om de Gemini-modellen te trainen en voor grounding in de Gemini-apps en Vertex AI. Google geeft aan dat het geen effect heeft op opname in Google Zoeken en geen rankingsignaal is.
AI-overzichten en de AI-modus steunen daarentegen op Googlebot en de zoekindex: die regel je met nosnippet, max-snippet of noindex, en sinds 31 augustus 2026 met de optie "Search generative AI control" in Search Console, die voor alle sites is uitgerold. Kies je voor uitsluiting, dan verdwijnen links en content uit deze functies, meestal binnen een paar dagen, en mist de site het verkeer dat ze opleveren, zonder dat dit als signaal voor de rest van Google Zoeken dient; het heeft echter niets met training te maken, die onder Google-Extended valt.
Apple
Applebot voedt onder meer de zoekfuncties van Spotlight, Siri en Safari, en de gegevens kunnen ook worden gebruikt om de foundationmodellen van Apple te trainen. Applebot-Extended crawlt geen enkele pagina: het is een naam die je in robots.txt gebruikt om training te weigeren, zonder uit de zoekresultaten van Apple te verdwijnen. Een belangrijk detail dat Apple benadrukt: als robots.txt Applebot niet noemt maar Googlebot wel, volgt Applebot de regels die voor Googlebot zijn geschreven. Applebot leest Crawl-delay niet, maar vertraagt uit zichzelf als de site traag of met fouten antwoordt.
| Naam | Opgegeven toepassing | robots.txt | Effect van een blokkade |
|---|---|---|---|
| GPTBot | Training (OpenAI) | Gerespecteerd | Content uitgesloten van training |
| OAI-SearchBot | Zoeken in ChatGPT | Gerespecteerd | Minder aanwezigheid in de zoekfunctie van ChatGPT |
| ChatGPT-User | Bezoek op verzoek van een gebruiker | Geldt mogelijk niet | Onzeker |
| ClaudeBot | Training (Anthropic) | Gerespecteerd, Crawl-delay gelezen | Toekomstige content uitgesloten van training |
| Claude-SearchBot | Zoeken in Claude | Gerespecteerd | Minder zichtbaarheid in de antwoorden |
| Claude-User | Bezoek op verzoek van een gebruiker | Gerespecteerd | Claude kan de pagina niet meer op verzoek lezen |
| PerplexityBot | Resultaten van Perplexity | Gerespecteerd | Afwezig in de resultaten van Perplexity |
| Perplexity-User | Bezoek op verzoek van een gebruiker | Doorgaans genegeerd | Gering |
| Google-Extended | Training en grounding van Gemini | Alleen token | Geen effect op Google Zoeken |
| Applebot-Extended | Training (Apple) | Alleen token | Geen effect op de zoekfuncties van Apple |
Het effect op je zichtbaarheid in AI
Het mechanisme is eenvoudig: een assistent kan alleen citeren en linken wat zijn zoekbot heeft kunnen lezen, of wat hij op verzoek kan gaan lezen. OAI-SearchBot, Claude-SearchBot of PerplexityBot blokkeren betekent dus afzien van een plek als bron in die antwoorden. GPTBot, ClaudeBot, Google-Extended of Applebot-Extended blokkeren verhindert volgens de documentatie van die bedrijven daarentegen niet dat je erin verschijnt: die keuze gaat over training, niet over citaten.
Zoekbots toelaten garandeert nog geen citaat: het maakt een citaat alleen mogelijk. De rest hangt af van de kwaliteit en relevantie van de content, net als bij klassieke SEO. De duurste valkuil ligt elders: Googlebot, Bingbot of Applebot blokkeren om "AI te blokkeren", waardoor de site uit de klassieke zoekresultaten zelf verdwijnt.
Een robots.txt die zoeken toestaat en training weigert, ziet er zo uit:
# Training: geweigerd
User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: Google-Extended
Disallow: /

User-agent: Applebot-Extended
Disallow: /

# Klassiek zoeken en AI-zoeken: toegestaan
User-agent: *
Allow: /
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php

Sitemap: https://www.example.com/wp-sitemap.xml
Pas de regel Sitemap aan je site aan en controleer voor het publiceren dat Googlebot en Applebot niet door een beperkende regel worden geraakt.
Serverbelasting, een echt probleem
Op gedeelde hosting kunnen bots die duizenden URL's doorlopen (winkelfilters, archieven, interne zoekopdrachten) de site vertragen voor echte bezoekers. Cloudflare meldde in juli 2026 dat training goed was voor 52% van de verzoeken van AI-bots die het in juni 2026 op zijn netwerk zag, tegen 22% in het voorjaar van 2025. Bekijk je logbestanden voordat je blokkeert: welke bot, welke URL's, hoe vaak. Daarna:
- Sluit oneindige ruimtes af (interne zoekfunctie, filtercombinaties) voor alle bots, in plaats van een hele bot te blokkeren.
- Gebruik Crawl-delay voor de bots die het lezen, zoals ClaudeBot. Google ondersteunt dit veld niet, en Applebot evenmin.
- Schakel paginacaching in: een pagina uit de cache kost weinig, wie de bezoeker ook is.
- Filter op netwerkniveau niet-aangemelde of misbruikende bots, met een applicatiefirewall of een CDN.
robots.txt is geen slagboom
robots.txt is een afspraak: de documentatie van Cloudflare wijst erop dat naleving vrijwillig is en dat het de toegang tot content technisch niet verhindert. In augustus 2025 beschuldigde Cloudflare Perplexity ervan niet-aangemelde bots te gebruiken, met de user-agent van een browser en andere IP-adressen, op testdomeinen die crawlen verboden. Twee praktische gevolgen:
- Een user-agentnaam bewijst niets. Elk script kan zich voordoen als GPTBot of Googlebot. Controleer het IP-adres: reverse DNS-lookup voor Google, JSON-lijsten die OpenAI en Perplexity publiceren.
- Voor een echt verbod heb je een blokkade op de server of het CDN nodig. Sinds 15 september 2026 vervangt Cloudflare zijn oude schakelaar "Block AI Bots" door drie onafhankelijke instellingen (zoeken, agents, training) en genereert het een beheerde robots.txt met contentsignalen. Let op welke optie je voor training kiest: volgens Cloudflare laat "Disallow AI Training" Googlebot, Bingbot en Applebot crawlen voor zoeken en blokkeert het de andere trainingsbots, terwijl "Block" ook deze drie bots tegenhoudt, zoeken inbegrepen.
Loopt je site via Cloudflare, denk er dan ook aan om in WordPress het echte IP-adres van bezoekers te herstellen, anders zien je logbestanden en je limieten alle bots achter dezelfde adressen: zie ons artikel over Cloudflare en het echte IP-adres.
AI-bots en aanvalsbots: haal ze niet door elkaar
Aangemelde AI-bots lezen je publieke pagina's. Aanvalsbots zoeken naar wp-login.php, xmlrpc.php, .env-bestanden of back-ups, en lezen robots.txt niet om jou een plezier te doen. Wie ze op dezelfde manier behandelt, neemt verkeerde beslissingen: nuttige bots uit angst blokkeren, of gevaarlijke scans negeren omdat ze zich voordoen als een zoekmachine. Ons artikel over bots, scanners en logbestanden legt uit hoe je ze uit elkaar houdt.
Op die tweede categorie richt WP Masquerade zich. De botvallen tellen verzoeken naar adressen die op je site niet bestaan maar waar aanvalstools naar zoeken (gevoelige bestanden, paden van de geïmiteerde software, afgesloten WordPress-adressen), zonder ooit een echte pagina mee te tellen. De Pro-versie voegt een log toe, automatische blokkering na meerdere vallen en ondersteuning voor Cloudflare om het juiste adres te blokkeren. De plugin beheert je beleid tegenover AI-bots niet: die keuze blijft in robots.txt en je CDN.
Bots van AI-bedrijven en zoekmachines downloaden ook je afbeeldingen: geoptimaliseerde bestanden verlichten die belasting (zie de beste plugins om afbeeldingen te optimaliseren).
Lees ook: MCP in WordPress: wat het Model Context Protocol verandert en hoe je het benut.
Om te onthouden
- Scheid drie beslissingen: training, AI-zoeken, bezoeken op verzoek.
- Training weigeren (GPTBot, ClaudeBot, Google-Extended, Applebot-Extended) haalt je volgens de bedrijven niet uit de antwoorden.
- AI-zoekbots blokkeren betekent afzien van citaten; ze toelaten garandeert geen enkel citaat.
- Blokkeer nooit Googlebot, Bingbot of Applebot om AI te treffen.
- robots.txt is vrijwillig: filter bij belasting en misbruik op de server of het CDN.
Bronnen
- OpenAI, Overview of OpenAI Crawlers (opent in een nieuw tabblad)
- Anthropic, crawlers en blokkeren (7 april 2026) (opent in een nieuw tabblad)
- Perplexity, Perplexity Crawlers (opent in een nieuw tabblad)
- Google, veelgebruikte crawlers en Google-Extended (bijgewerkt op 15 oktober 2026) (opent in een nieuw tabblad)
Andere geraadpleegde bronnen: officiële documentatie en officiële pagina's van de leveranciers.


